Reprendre le contrôle : expérimenter l’intelligence artificielle locale avec llama.app
(Ou comment réconcilier sa pratique numérique avec la souveraineté locale, sans pour autant sacrifier le confort d’utilisation.)
On entend souvent dire que nous vivons dans l’ère de la « donnée » et de l’intelligence artificielle cloud. Tout y passe : nos textes, nos projets, nos brouillons de cours et nos notes de travail, s’envolent sagement vers des serveurs distants gérés par des prestataires dont la promesse de confidentialité repose sur des conditions générales d’utilisation que personne ne lit jamais.
En tant que formateur et observateur attentif des évolutions technologiques, cette centralisation systématique a toujours posé question. Les enjeux de souveraineté, de maîtrise des outils et de respect de la vie privée ne sont pas de simples postures idéologiques ; ce sont des conditions de base pour un usage éclairé du numérique. Alors, lorsqu’un projet comme llama.app émerge pour simplifier l’accès aux modèles locaux, il mérite qu’on s’y attarde.
Une application, une promesse : ramener l’intelligence sur sa machine
Pour poser les bases, llama.app propose d’installer une application simple (compatible Windows et macOS) permettant d’exécuter des modèles de langage de pointe — qu’il s’agisse des modèles Llama ou d’alternatives performantes comme Qwen, Gemma ou Mistral au format GGUF — directement sur votre propre matériel.
Pas de clé API payante, pas de flux de données sortants : le traitement s’exécute localement, en mobilisant les ressources de votre processeur ou de votre carte graphique. C’est un changement de paradigme intéressant : l’outil devient un logiciel autonome, au même titre qu’un traitement de texte ou un lecteur multimédia, qui fonctionne indépendamment d’une connexion permanente à des serveurs tiers.
L’ergonomie au service de la pédagogie
Dans le domaine de l’autoformation et de la transmission, on constate régulièrement que la complexité technique constitue le premier frein à l’appropriation des outils. De nombreuses initiatives open source restent confidentielles parce que leur installation ressemble à un parcours du combattant en ligne de commande.
Sur ce point, l’approche de llama.app se révèle particulièrement soignée :
-
Une installation fluide : L’application se déploie sans nécessiter de compétences en programmation ou une configuration lourde de l’environnement de développement. il suffit de la télécharger sur le site en lien. Le site signale que c’est une version Windows 11 mais je l’ai installé sur un Win 10 et ça fonctionne parfaitement.
-
Une gestion intelligente des ressources : L’outil s’appuie sur les standards de l’écosystème (notamment les caches compatibles avec Hugging Face), ce qui évite les doublons de stockage inutiles si vous disposez déjà de modèles sur votre disque.
-
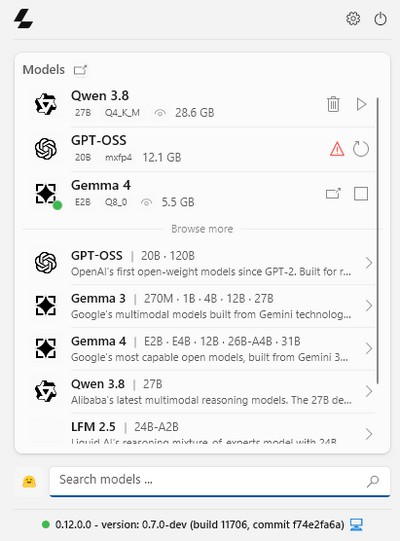
Une intégration discrète : Qu’il s’agisse d’un accès rapide via un raccourci clavier ou d’une interface de discussion épurée, l’outil s’intègre dans l’environnement de travail habituel sans perturber les flux existants. La fenêtre se cache dans la barre des tâches et propose directement l’installation de différents modèles d’IA.
De la théorie à la pratique : les usages possibles
À l’usage, la question centrale est celle des performances et de la pertinence. Selon les capacités de votre machine, le choix du modèle s’ajuste pour trouver le juste équilibre entre vitesse de génération et finesse d’analyse. J’ai testé sur un I7 de 6e Génération, 32 Go de Ram en DDR4 et une carte graphique Quadro P1000, pas la meilleure configuration pour faire tourner une IA locale et un modèle comme GEMMA 4 me répond de façon fluide : Pour comparatif, il écrit un quiz de 10 questions en moins de 2 minutes.
Les applications pédagogiques et professionnelles sont multiples :
-
L’expérimentation sécurisée : Idéal pour tester des scénarios d’écriture, analyser des documents ou concevoir des structures de cours sans exposer des données sensibles.
-
Le travail hors connexion : Retrouver la liberté d’utiliser ces technologies en déplacement, sans dépendre de la qualité d’une connexion réseau.
-
L’ouverture technique : Pour les utilisateurs plus avancés, l’outil déploie un serveur local compatible avec les standards d’API ouverts, permettant d’interfacer le modèle avec d’autres logiciels de rédaction ou d’assistance au code.
En conclusion
L’intérêt d’une solution comme llama.app ne réside pas seulement dans sa performance technique, mais dans ce qu’elle permet en matière d’autonomie. En abaissant la barrière à l’entrée des modèles locaux, elle offre une alternative crédible et respectueuse des données, accessible à tous ceux qui souhaitent observer, comprendre et maîtriser les outils qu’ils utilisent au quotidien. C’était déjà le cas avec d’autres systèmes mais il fallait vraiment mettre les mains dans le cambouis alors que là, l’installation et l’usage est particulièrement simple.
Et comme d’habitude, merci de nous parler de vos usages de ça, notamment avec vos configurations, en commentaires.


Commentaires récents